ローグライトFPS「Sector Dive」を作り直して、「Sector Dive Extended」として公開した - B-Teck! で紹介した Sector Dive Extended を作っていたときの、開発の進め方の話。
Claude Codeに作ってもらったゲームが面白かったので、AIに作り続けてもらう仕組みを整えた - B-Teck! では、壊れずに作り続けるためにテストや CI を足していった話を書いた。 今回も実装は AI に任せていて、自分は遊んで感想を返したり、方針を決めたりしている。
動くものができて、やりたいことが増えた。前作よりもコードやタスクの規模が大きくなり、Claude の制限に頻繁に当たるようになった。 Max プランへのアップグレードや、ほかの AI エージェントのサブスクも検討して、コスト面で優れる OpenCode Go を採用した。
実装を任せられる量が増えると、今度はレビューと確認が追いつかなくなる。別の AI エージェントが書くので、これまで Claude Code に任せていれば守られていた書き方や作りの決まりも、守られるとは限らない。 そこを、タスクの書き方と確かめる道具で少しずつ補っていった。その流れを振り返ってみる。
OpenCode Go
10月の終わりから、実装は OpenCode に任せるようになった。OpenCode は、Claude Code と同じようにターミナルで動くコーディングエージェントで、いろいろな会社のモデルを選んで使える。
OpenCode Go は月10ドルのプランで、決まった枠の中で DeepSeek などのモデルを使える。主に使っている DeepSeek V4.1 Flash は、枠が API の料金に直して月80ドル分あり、5時間あたり約3万5千回まで投げられる(2026年10月時点)。今の使い方では、まず使い切れない。
Claude Code と比べると、コストはかなり安い。 ファイルを6つ直して3つ足すくらいのタスクで、実装1本が約0.025ドルだった。毎回、長いやりとりを送り直しているけど、そのほとんどがキャッシュから読まれる。別の日に見たときは約99%がキャッシュで、安さのほとんどはここから来ている。 半日回した日で比べると、Claude の週の枠を約23%使ったのに対して、OpenCode の月の枠は約5%しか減っていなかった。
OpenCode を入れる前と後で比べると、こうなっている。
| 入れる前 | 入れた後 | |
|---|---|---|
| PR の本数(稼働日あたり) | 7.7本 | 9.9本 |
| 追加した行のうち、テストの割合 | 8% | 35% |
テストの割合が上がったのは、タスクの完了条件に挙動のテストを書くようにしたから。
分担
最初に渡した7本は、Claude が作業範囲と完了条件をタスクとして書いてから渡した。変える箇所まで指定したものから、何を変えるかの判断まで任せたものまであったけど、どれも差し戻しなしで通った。
その後、別のゲームの試作で、これまでのようにざっくりとやりたいことを Markdown にまとめて渡してみた。動くものは出てきたけど、かなり時間がかかった。出てきた実装もいまひとつだった。 なので、Claude が要件からタスクを分けて、作業範囲と完了条件を書いてから渡す形に揃えた。
今の分担はこんな感じ。
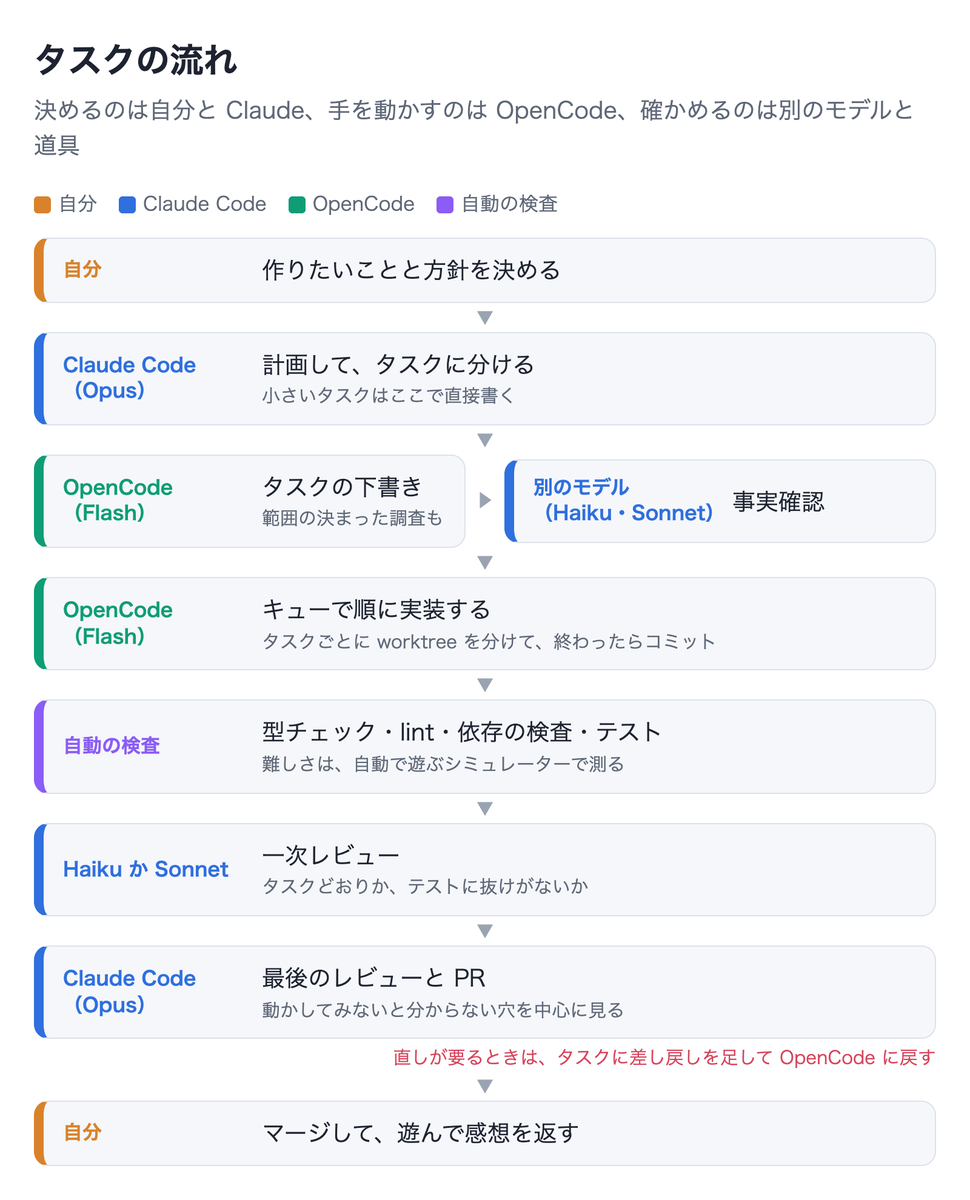
大きいタスクは Flash に下書きさせて、事実を確かめてから渡す。小さいタスクは、下書きを通さずに Claude が直接書いている。範囲の決まった調査も、Flash に任せて結果をファイルに書かせている。
比較のために、上位のモデル(DeepSeek V4.1 Pro)にも同じタスクをやらせてみた。
| タスク | Flash | Pro | 結果 |
|---|---|---|---|
| 文書の組み直し | 365秒 | 777秒 | どちらも完了条件を満たした。範囲の解釈も同じ |
| 1600行のファイルを分ける(分け方も任せる) | 504秒 | 2243秒 | 骨組みはほぼ同じ形。同じ設計の穴が両方に残った |
Pro は2〜4.5倍遅く、出来は少し丁寧な程度だった。明確なタスクを渡す分には、実装を Flash で回して、気になった所を差し戻すほうが速い。
一次レビューでは、作業内容がタスクどおりか、テストに抜けがないかを Haiku や Sonnet に見てもらう。最後に Opus が、動かしてみないと分からない穴を中心にレビューする。 下書きの事実確認を書いたのとは別のモデルに任せているのは、同じモデルで確かめても漏れが見つかりにくかったから。
タスクとキュー
Claude の枠が切れているあいだもタスクを進められるように、まとめて回すスクリプトを作った。 キューに並べたタスクを、タスクごとに作業用のフォルダ(git の worktree)を分けて順に実装させ、終わったらコミットまでしてくれる。
| 回したとき | 本数 | かかった時間 | 止まった本数 |
|---|---|---|---|
| 最初 | 11本 | 約3時間 | 1本(先に回したタスクと同じファイルを触っていた) |
| 10/31 夜 | 6本 | 約40分 | 0本 |
| 11/1 | 7本 | 約37分 | 0本 |
タスクの消化が速くなると、今度は Claude 側のレビューが詰まり所になる。7本を40分弱で回したときは、レビュー待ちのタスクが並んだ。タスクの指示に間違いがあると、その上に積んだタスクまで同じ間違いを引き継いでしまう。 繰り返し差し戻されるタスクもあった。差し戻しの傾向を見てタスクに書く内容を見直し、タスク自体をレビューするステップも足した。これで、実装のレビューにかかる手間を下げていった。
それでもレビューで見きれない所は、道具に任せることにした。
確かめる道具
ゲームの難しさなどは、挙動のテストだけでは確かめられない。 そこで、数値で比べられる仕組みを作って、ある程度までは AI が自分で確かめられるようにした。この仕組み自体は OpenCode を入れる前からあったけど、実装を任せる量が増えてから、使う場面が増えた。
使っているのは、ゲームを最後まで自動で遊ぶシミュレーター。 人と同じ入力で操作しながら、型ごとにレベルアップのときの選び方や、敵を狙う腕、避けるかどうかの基準を変えてある。どこまで進めて、どこで負けるかを見られる。 画面を描かずにゲームを進めるので、実時間の数百倍で回る。数時間分のプレイを何本も続けて回して、ログを取れるようになった。
ARCADE の難しさを決めたときは、深度の係数を 2 にすると8本中8本がクリア、3 にすると8本中0本だった。目安は「1回でクリアできるのが3分の1〜半分」だったので、間の 2.5 を試して8本中6本。ボットは人より正確なので、人だと少し下がる見込みで 2.5 にした。
通しで遊ばせたことで、進行不能バグも見つかった。ロックダウンの部屋やボス部屋に入ってすぐ引き返すと、部屋の外に取り残されて先に進めなくなる、というもの。
依存の向き
前回の記事で、engine からゲームは import しない、という決まりにしたことを書いた。 ただ、これはルールとして書いただけで、実際に守られているかを確かめる仕組みは無かった。別の AI エージェントに実装を任せるなら、書いてあるだけでは足りない。
そこで、dependency-cruiser(import の向きを検査するツール)で確かめるようにした。今の決まりは4つ。
- engine はゲームを読まない
- 循環させない
- ゲームは engine の公開の入口(フォルダごとの
index.ts)からだけ読む - engine の中でいちばん下の層(core)は、ほかのフォルダを読まない
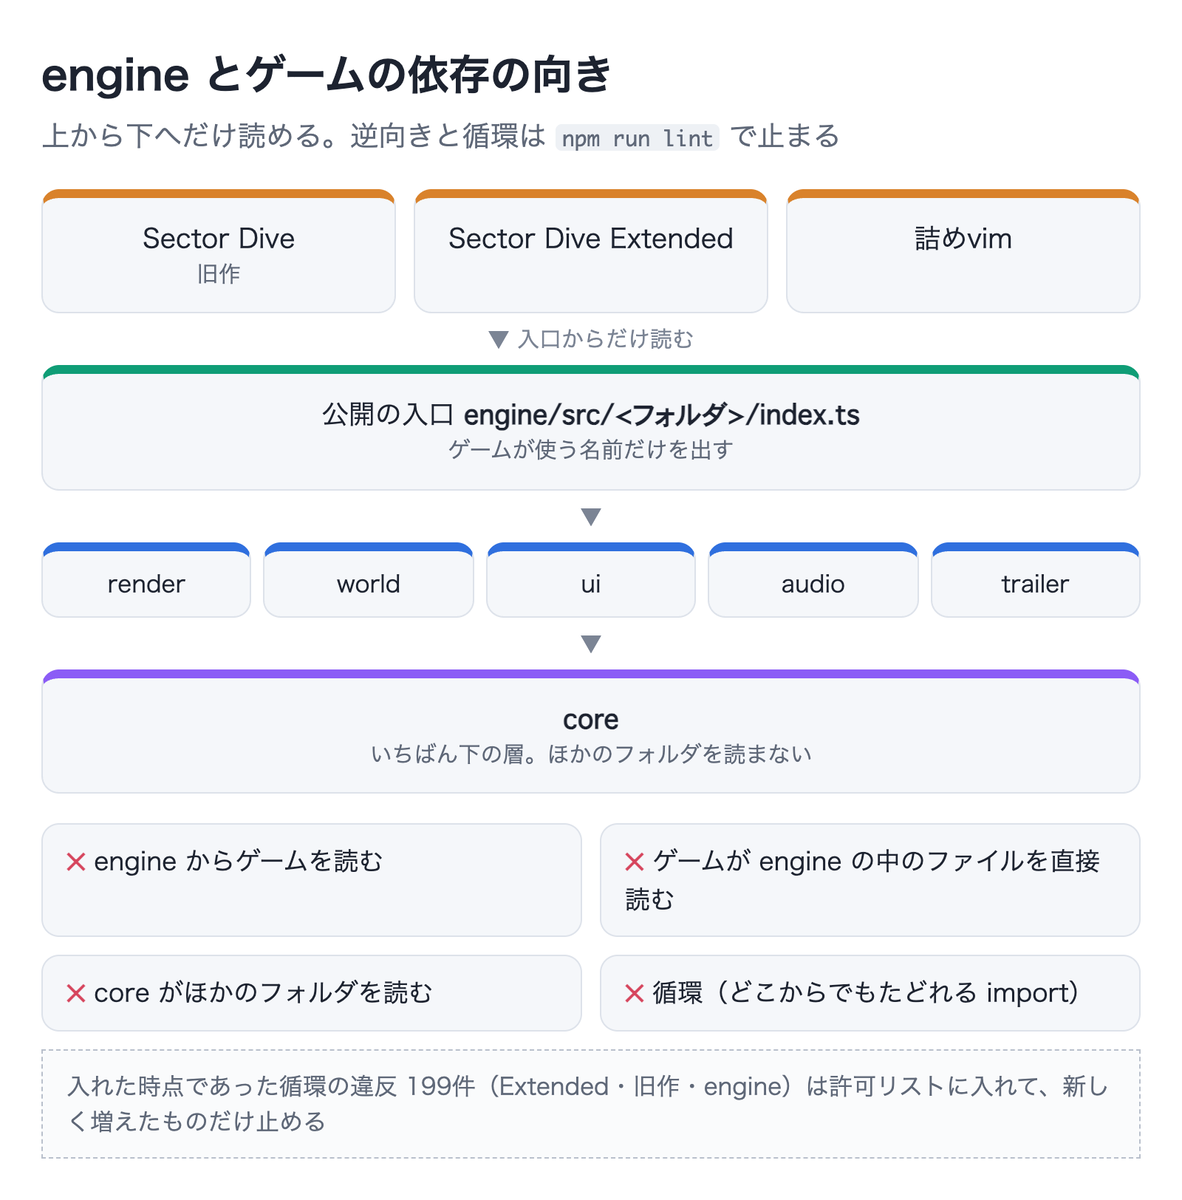
最初の2つを入れてみると、循環の違反が199件あった。Extended・旧作の Sector Dive・engine の中にまたがっていて、いちばん大きいのは Extended の37ファイルが互いに参照し合っているかたまりだった。起動の順番を決めてあるので動いてはいるけど、どこから読んでもたどれてしまう状態だった。
これを全部直すのはタスクとして重いし、先に作業したいタスクもあった。なので、この時点の違反は許可リストに入れて、新しく増えた違反だけを止めるようにした。 lint と一緒に検査しているので、タスクの指示やレビューをすり抜けた違反も見つかる。あるタスクは、指示どおりに import を足すと循環が10件増える内容だった。書いた Claude も、実装した Flash も気づいていなかったけど、レビューで検査を流して見つかり、登録して渡す形に直した。
あとの2つは、次の作品に移る前の整理で足した。入口からはゲームが使う名前だけを出しているので、engine の中のファイルを変えても、ゲーム側を触らずに済む。
まとめ
Claude の枠は、計画やレビューのような決めることに使い、手を動かす実装は OpenCode に任せるようになった。 タスクの書き方や事実確認、シミュレーターや依存の検査を少しずつ足していったので、任せても実装の質は落とさずに回せている。
手が空いた分で、これまで据え置いていた改善やドキュメントの整備も、ゲームの開発と合わせて進められた。OpenCode を入れた最初の週は、マージした78本の PR のうち48本がリファクタやドキュメント、開発まわりの整備だった。
